結論
AIチャットボットの「精度」は、テストの作り方と採点者しだいで簡単に嘘をつきます。実際に私たちは、モデルを賢いものに入れ替えたのに評価点が下がるという経験をしました。原因はチャットボットではなく、採点する側のAIが賢くなかったことでした。
「なんとなく良さそう」は、なぜ危ないのか
チャットボットを入れた会社の多くが、同じところでつまずきます。本当に正しく答えているのか、確かめるのは意外と難しいという問題です。
この不安は数字にも出ています。帝国データバンクの2026年3月の調査では、生成AIを業務で活用している企業は34.5%、そのうち86.7%が効果を実感している一方で、懸念・課題の1位は「情報の正確性」で50.4%でした。情報システム部門を対象にした別の調査でも、出力精度の不確実性(ハルシネーション)を課題と挙げた人は35.2%で、セキュリティに次ぐ2位です。
つまり、効果は感じているのに、正しさだけが不安。これが今の共通した悩みです。
私たちが作っているKotae AIも同じ道を通りました。社内資料やWebサイト、PDF、スプレッドシートを読んで答えるチャットボットです。調べものが速い新人、というイメージが一番近いと思います。速いけれど、新人です。
最初のテストは、誰かが質問を打ち込んで、答えを読んで、「まあ良さそう」とうなずくだけでした。今振り返ると、少し恥ずかしいです。
目が覚めたのは、お客様からの1通のメッセージ
ある日、こんな連絡が来ました。「お店が2019年に閉店したとチャットボットが答えましたが、閉店していません」。
質問そのものに間違った前提が入っていました。正しい答えは「資料に閉店の記載はありません」です。でもチャットボットは、それらしい理由を作って答えてしまいました。
怖いのは、間違っていたことではありません。間違いが、正しそうに聞こえたことです。明らかに変な答えなら、人は無視します。もっともらしい間違いは、そのまま信じられます。
ここで気づきました。「良さそう」というだけではテストになりません。チャットボットにも、ちゃんとした試験が必要です。
どんな質問でテストすればいい?
私たちは「ゴールデンデータセット」と呼ぶ問題集を作りました。答えを人間が先に確認した質問のリストです。最初は手書きで40問ほど。今は7種類、数百問まで増えました。
特に大事なのが、お客様のあのメッセージから生まれた2種類です。
前提が間違っている質問:「なぜ2019年に閉店したのですか?」
資料では答えられない質問:「明日の天気は?」
どちらも正解は「お答えできません」です。「わかりません」と答えるチャットボットは、地味に見えるかもしれません。しかし、答えられないことまでそれらしく答えてしまうチャットボットには、リスクがあります。私たちが目指したのは、地味なほうです。
答えられないことを答えられないと言えるかどうか。それは、チャットボットにとって重要な性能の一つです。
これは導入する側にも使えるチェック方法です。自社の資料に絶対に書いていないことを、わざと聞いてみてください。資料にない内容まで断定して答えるようなら、注意が必要です。
AIの回答を、AIに採点させても大丈夫?
質問が100問を超えたあたりで、全部を人が読むのは無理になりました。そこで別のAIに採点させることにしました。質問と、正解と、チャットボットの答えを読ませて、点数をつけさせます。
これはうまくいきました。うまくいきすぎて、私たちは自分で答えを読むのをやめてしまいました。
そして、おかしな週が来ます。
回答を作るモデルを新しいものに入れ替えました。新旧の回答を読み比べると、明らかに良くなっていました。説明がていねいで、ひっかけ質問もきちんと断るようになりました。
それなのに、評価点は下がりました。
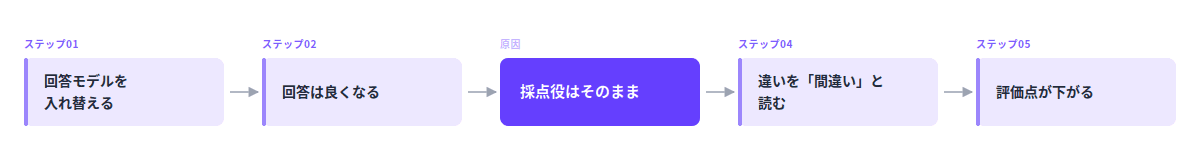
回答モデルだけを新しくしたときに起きたこと。原因はチャットボット側ではなく、採点役を据え置いたことにある点に注目してください。
パイプラインが壊れたと思い、検索部分を1日かけて調べました。異常なしです。最後に、古いモデルと新しいモデルの答えを並べて、採点理由を読みました。
原因ははっきりしていました。新しい答えは、良くなったせいで減点されていたのです。採点役のAIが理解できない細かい違いを含んでいると、それを「間違い」と読んでしまう。逆に、古いモデルの短くて平たい答えは、正解文とそっくりなので満点でした。
チームの誰かがこう言いました。「生徒に先生の答案を採点させていた」。
生徒が採点すると、こうなります。
自分が理解できない答えを減点する
自分が書きそうな答えに高い点をつける
自信のある正解と、自信のある間違いを区別できない
結果として、点数は採点者のレベルに引きずられます。チャットボットが採点者より賢くなった瞬間、その差が減点になるのです。
同じことは、論文にも残っています
LLM評価の代表的な研究「MT-Bench」には、採点役が間違えた記録がそのまま載っています。
問題:|x + 5| < 10 を満たす整数は何個ですか?
回答A:19個。式は書いていません。
回答B:場合分けをていねいに書いたうえで、20個。
正解:19個(−14から4までの整数)
採点役はGPT-4で、「まず自分で解いてから採点しなさい」という指示つきでした。それでも採点役は、回答Bの解き方をほぼそのまま書き写し、数え間違いごと採用して、回答Bを選びました。同じ問題を単独で解かせると、GPT-4は正しく19個と答えます。
短くて正しい回答が、長くて間違った回答に負けたわけです。この研究では10問の算数の問題で採点の失敗を数えていて、通常の指示では20回中14回、「自分で解いてから」の指示でも20回中6回、正解を渡したときは20回中3回まで減りました。
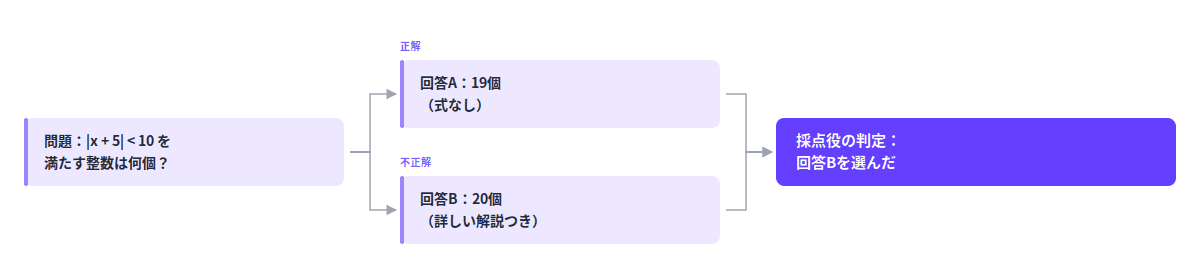
正解が19個の問題で、採点役が選んだのは20個と答えたほうでした。式を書いていない正しい回答が、ていねいに説明された間違った回答に負けている点に注目してください。
採点役をより強いモデルに変えたところ、新しいチャットボットの点数は古いものを大きく上回りました。最初から目で見て分かっていたとおりの結果です。
同じことは、そのあとも起きています。下はある時期の実験ログです。下がった理由と上がった理由が別物だという点だけ見てください。
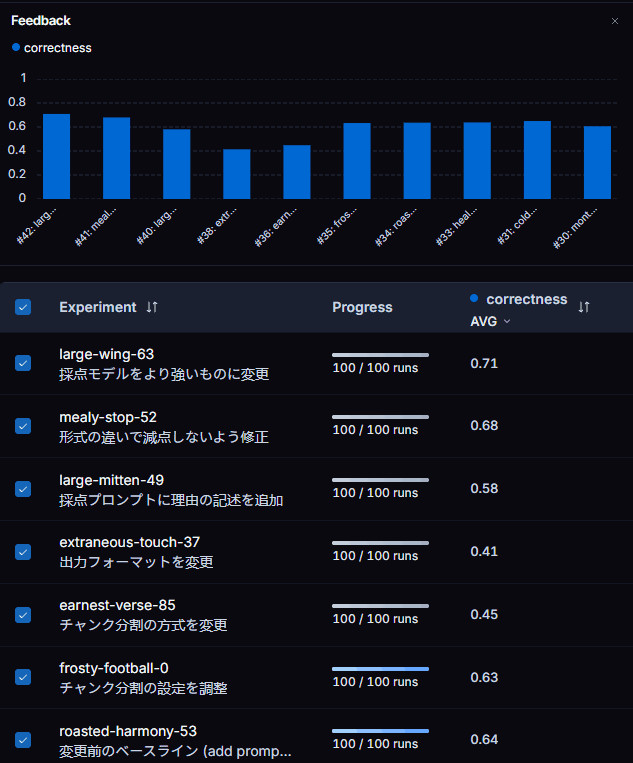
実際の実験ログ。#36と#38で0.41まで落ちたのはチャットボット側の変更(チャンク分割と出力フォーマット)が原因ですが、#40から#42で0.71まで戻ったのは採点役を直した結果で、チャットボットには一切触れていません。理由を書かせ、形式の違いで減点しないようにしただけで、同じ回答の評価がここまで変わります。採点役が違う以上、#38と#42の数字は直接比べられません。画面は日本語未対応のため英語表示です。
この現象は私たちだけの話ではありません。LLM同士の評価を検証した技術レポートでも、同じモデル・同じサンプルでも評価が大きくぶれること、専門知識の不足、情報量の多さで回答が過大評価されることが課題として挙げられています。海外の研究でも、回答の位置や長さ、書式といった中身と関係のない要素が判定を左右することが指摘されています。
ここから学んだルールはシンプルです。採点役は、採点される側と同じかそれ以上に賢く、そして正解そのものが正しくなければいけない。 チャットボットを新しくするなら、先に採点役を新しくする。採点役はテストのときにしか動かないので、費用はほとんど気になりません。
人間は、何をチェックすればいい?
採点をAIに任せたあとも、私たちは週に1回、点数の低い回答をみんなで読む時間を残しました。だいたい火曜の午後です。今では一番役に立っている1時間になりました。
その部屋で分かったことです。
「不正解」と判定された中には、実は正しい回答もありました。営業時間の質問で、正解は「9時から18時」。チャットボットの答えは「朝9時から夕方6時まで、祝日は休業」。採点役は不一致として減点しましたが、答えとしてはこちらのほうが親切です。同じ情報は資料のあちこちに違う書き方で載っていて、良い答えはそのどこから来てもいいのです。
正解のほうが間違っていることもありました 。 古い価格表をもとに作った正解が3つ見つかりました。チャットボットは新しいページを読んでいて、最新であるがゆえに減点されていました。今は、お客様が資料を更新したら、同じチケットで問題集も見直します。
採点役は言葉づかいに細かかった。 正解が「300ページ」、答えが「約300ページ」というだけで減点されたことがあります。それ以来、採点役には点数の前に理由を書かせるようにしました。おかしな理由は、読めばすぐ分かります。
採点役は、中身と関係ないところでも判定を変えます
同じ研究に、もう一つ分かりやすい記録があります。
問題:日本でビジネスをするときのマナーには、どんなものがありますか?
品質の近い2つの回答を並べて採点役に見せました。1つ目を先に置くと、採点役は「こちらのほうが整理されていて詳しい」と判定しました。並び順を入れ替えただけで、判定は逆になりました。 中身は何も変えていません。
順番を入れ替えても同じ判定になった割合は、GPT-4が65.0%、GPT-3.5が46.2%、Claude-v1が23.8%でした。Claude-v1は75%の確率で、先に置かれた回答を選んでいます。
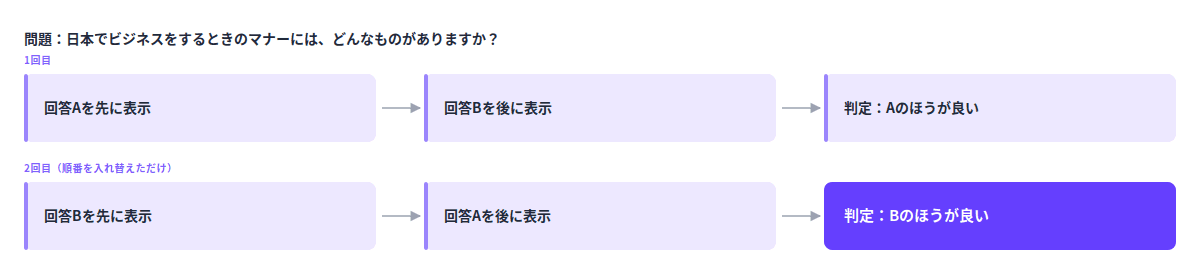
同じ2つの回答を、並び順だけ入れ替えて2回採点させた結果です。中身は一切変えていないのに判定が逆になっている点に注目してください。
だから私たちは、点数そのものより、理由を読むことに時間を使っています。
スコアが下がる場所は、何を教えてくれる?
もうひとつ、数字で見る価値がはっきり分かった話があります。
長いあいだ、うちのチャットボットは文章の質問に強く、価格表の質問に弱いままでした。値段の質問は難しいのだろう、と勝手に思っていました。
そこで「2,000円以下の本は何冊ありますか」のような数字の質問を問題集に足したところ、失敗があまりにきれいに並びました。失敗した質問は、すべて表に関するものでした。
原因は、Webページを取り込むツールのバグでした。すべてのページで、すべての表を静かに落としていたのです。チャットボットは価格表を一度も見ていませんでした。数字が苦手だったのではなく、目を閉じて答えていたわけです。
質問をいくつか試すだけの確認では、こうした問題は見つけにくいものです。
今日からできること
中小企業がこの領域で遅れているのは、やる気の問題ではありません。総務省の情報通信白書でも、中小企業では「方針を明確に定めていない」との回答が約半数を占めると指摘されています。進め方が決まっていないだけです。
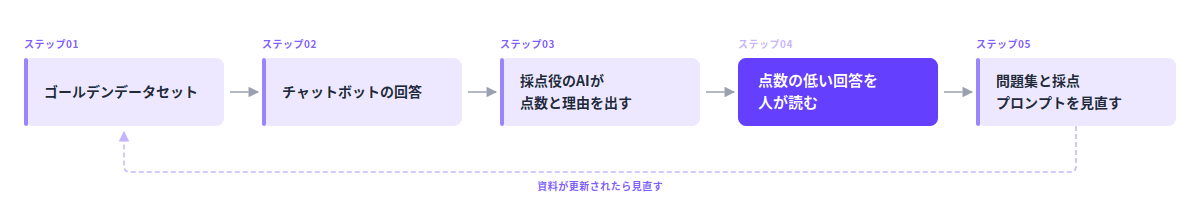
私たちが毎週回している評価サイクル。採点をAIに任せたあとも、点数の低い回答を人が読む工程が残っていること、そして資料が更新されるたびに問題集そのものを見直すことに注目してください。
私たちが今やっていることは、そのまま導入側のチェックリストになります。
答えを確認済みの質問リストを作る。資料が更新されたら、リストも見直す
前提が間違っている質問と、資料にない質問を必ず混ぜる
採点役のAIが、回答内容を十分に評価できるか確認する
採点役には、点数だけでなく理由を書かせる
2つの回答を比べさせるときは、並び順を入れ替えて2回採点する
低い点の回答を、人が定期的に読む
良し悪しは、同じ質問と同じ採点役で新旧を比べて判断する。単独の点数では判断しない
平均点が上がっても、答えるべきでない質問に答え始めたら、その変更は採用しない
結局、何が一番難しかったか
始めたころは、チャットボットを作ることが一番大変だと思っていました。違いました。本当に難しいのは、それが良いかどうかを知ることです。
チャットボットの評価は、ベンチマークを回す作業というより、学校を運営する仕事に近いです。ひっかけも含んだ公平な試験、内容を本当に理解している採点者、そして採点者の仕事をときどき疑う人間が必要です。
もし社内でチャットボットを使っているなら、担当者にこう聞いてみてください。「誰が採点していて、その採点者が正しいとなぜ言えますか?」。長い沈黙が返ってきたら、それも十分に有益な情報です。
自社の資料で同じことを試してみたい方は、Kotaeの無料トライアルで、答えが分かっている質問を10個だけ投げてみてください。→ Kotaeの無料トライアル
あわせて読みたい
チャットボットが賢くなったのに、点数が下がった理由
採点するAIが原因だった理由から、正しさを確かめる質問の作り方、今日からできるチェックリストまで学べます。

Kotaeのデザイン:使いやすいAIチャットボットのために、私たちが選んだ4つの判断
なぜ従来のサポートツールは使いにくいのか?「Kotae」デザイナーが、使いやすさを重視した4つの設計判断を解説します。

AIがExcel・CSVの数字を間違える理由
なぜ多くのAIツールは表計算ファイルで誤った答えを返すのか。Kotaeがどう対応しているかを、わかりやすく解説します。

中小企業のサポートを自動化する方法【2026年版】
中小企業がカスタマーサポートを自動化するための2026年版ガイド。手順・費用・ツール選びをまとめて紹介しています